Ein Modell zum Auswählen
Wie der Kanal Last Week in AI berichtet, bewertet CLM-8B mögliche Aktionen, statt für jede kleine Entscheidung eine lange Antwort zu formulieren. Andrey Kurenkov und Jeremie Harris erklären die Veröffentlichung in Podcastfolge 259. Das Modell erhält eine Situation und mehrere mögliche Handlungen und bewertet, welche am besten passen.
Die Folge beschreibt einen System-One-Ansatz: eine schnelle Entscheidungskomponente innerhalb eines größeren Agenten. Ein Sprachmodell kann die umfangreichere Planung übernehmen, während eine spezialisierte Komponente zwischen festgelegten Optionen wählt. Der Podcast vergleicht diese Rolle mit Jev, einem Dienst für strukturierte Entscheidungen.
Wie die Bewertung funktioniert
Der Kanal beschreibt ein unverändertes Basismodell mit acht Milliarden Parametern und einen zusätzlich trainierten Projektionskopf mit rund 20 Millionen Parametern. Das Basismodell wandelt Text in Zahlenrepräsentationen um; die kleine Zusatzkomponente unterstützt den Vergleich zwischen Situation und Aktionen. Wiederkehrende Kandidaten lassen sich speichern, damit ihre Darstellung nicht jedes Mal neu berechnet werden muss.
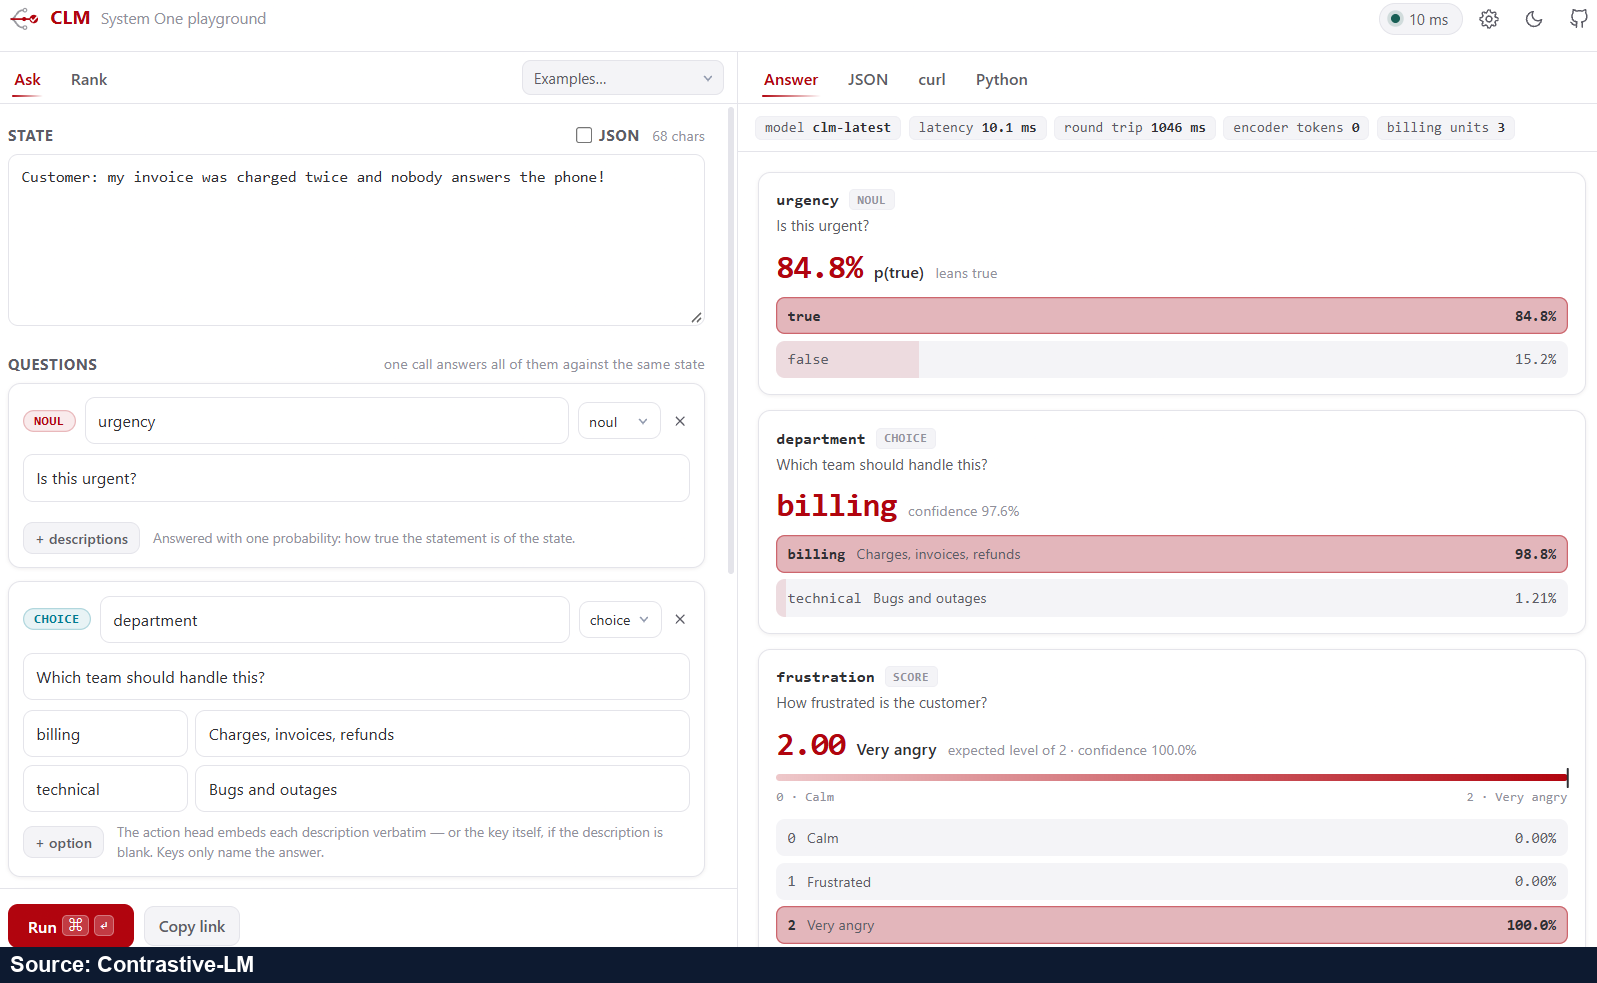
Im Playground wird das mit verschiedenen Fragetypen sichtbar: Ja oder Nein, Auswahl einer Abteilung oder eine Bewertung. Das Beispiel verbindet eine Kundenmeldung mit getrennten Fragen zu Dringlichkeit, Zuständigkeit und Verärgerung. Die Ausgabe zeigt die Verteilung über die verfügbaren Antworten statt eines frei geschriebenen Absatzes.
Tempo, Tests und Veröffentlichung
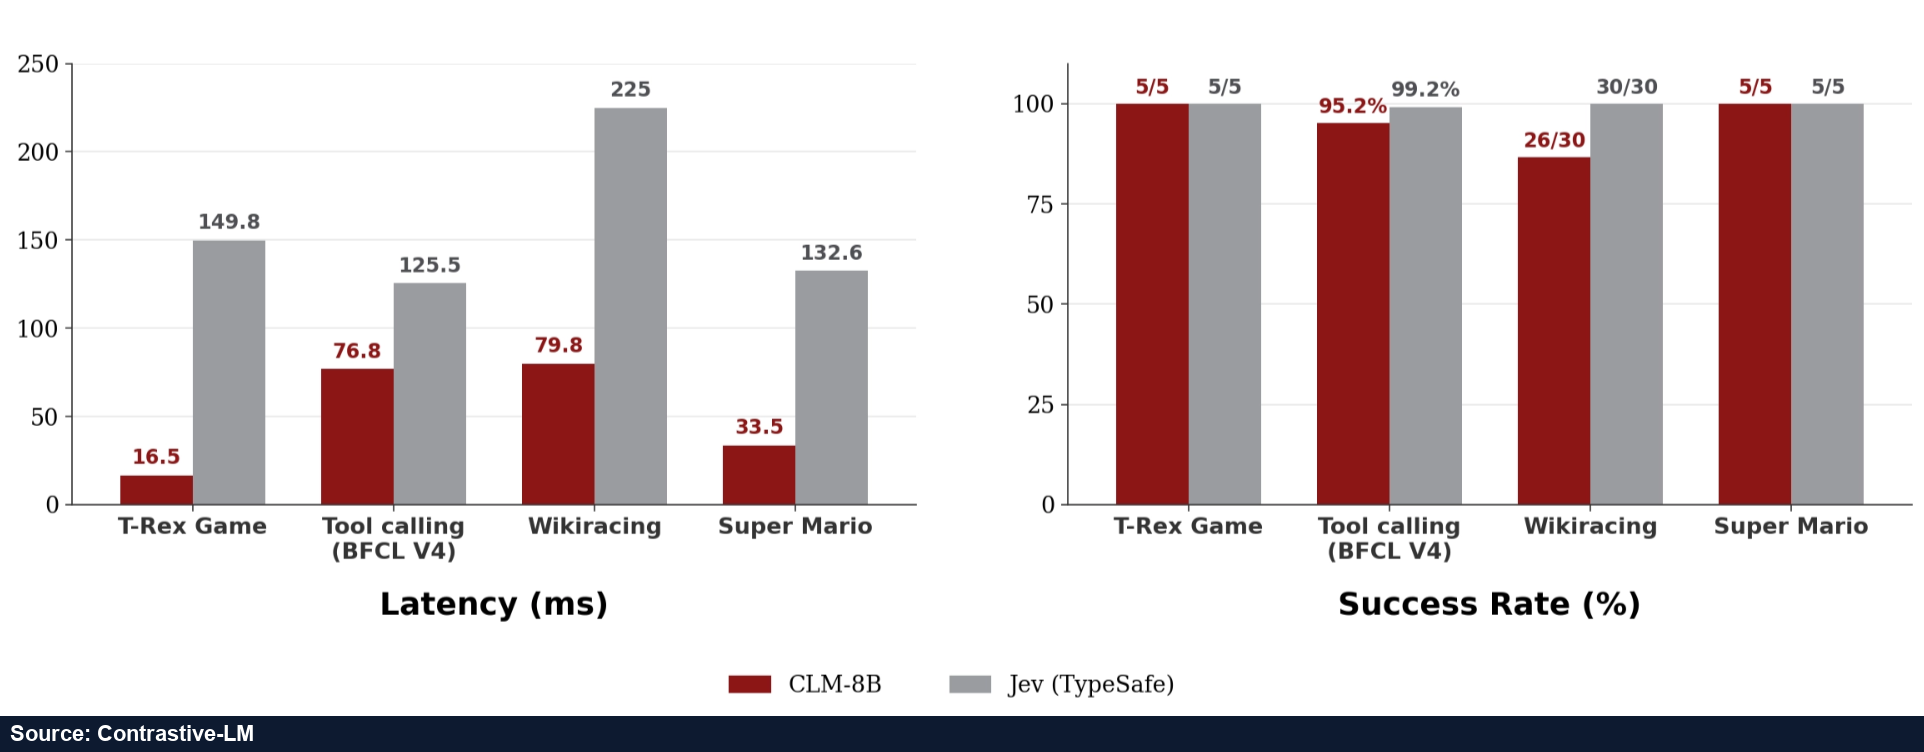
Der Kanal nennt in den Projekttests bis zu neunfache Geschwindigkeit gegenüber Jev. Geprüft werden unter anderem das T-Rex-Spiel, Werkzeugaufrufe, WikiRacing und Super Mario. Der Vergleich enthält Antwortzeit und Erfolgsquote; die Geschwindigkeitsangabe gehört zu diesen getesteten Aufgaben.
Das Projekt setzt CLM außerdem als Prüfer ein, der aus mehreren Lösungsvorschlägen für Programmieraufgaben auswählt. Die veröffentlichten Grafiken zeigen DeepSWE und Terminal-Bench 2.1. Code und Modellgewichte stehen unter Apache 2.0 bereit. Kurenkov und Harris verbinden das mit kompakten Entscheidungsmodellen, die sich mit größeren Sprachmodellen kombinieren lassen.


