
Was Selbstverbesserung bedeutet
Wie der Kanal Last Week in AI berichtet, verbessert ein rekursiv selbstverbesserndes System nicht nur Antworten, sondern auch den Weg zu weiteren Verbesserungen. Andrey Kurenkov und Jeremie Harris besprechen am Ende von Folge 259 die Arbeiten The Last AI Built by Humans und Dream-RSI. Die erste ordnet das Forschungsfeld; die zweite stellt eine Methode zur Verbesserung der Erkundung vor.
Der Kanal nennt heutige Programmieragenten als ersten Schritt: KI hilft Forschern, Arbeiten schneller auszuführen. Ein System, das auch seine Verbesserungsstrategie auswählt, nützliche Erfahrungen sammelt und seine Lernumgebung verändert, würde weitere Teile dieses Prozesses übernehmen.
Fünf Stufen der Autonomie
Die erste Arbeit unterscheidet fünf Stufen. L1 betrifft die Ausführung von Verbesserungsarbeit. L2 ist die Auswahl einer Verbesserungsstrategie. L3 umfasst das Sammeln nützlicher Erfahrungen oder Lernsignale. L4 betrifft die Anpassung der Verbesserungsumgebung. L5 bedeutet, den Verbesserungsmechanismus selbst weiterzuentwickeln.
Kurenkov und Harris nutzen diese Einteilung, um bessere Prompts oder Werkzeugkonfigurationen von tieferen Änderungen des Lernprozesses zu unterscheiden. Sie sprechen über den Aufwand für Umgebungen zum verstärkenden Lernen und die unterschiedlichen Ziele beim ersten und späteren Training. Recheneffizienz ist ein wiederkehrendes Ziel, die Gestaltung hilfreicher Rückmeldungen ein weiteres.
Dream-RSI nutzt Erfahrungen erneut
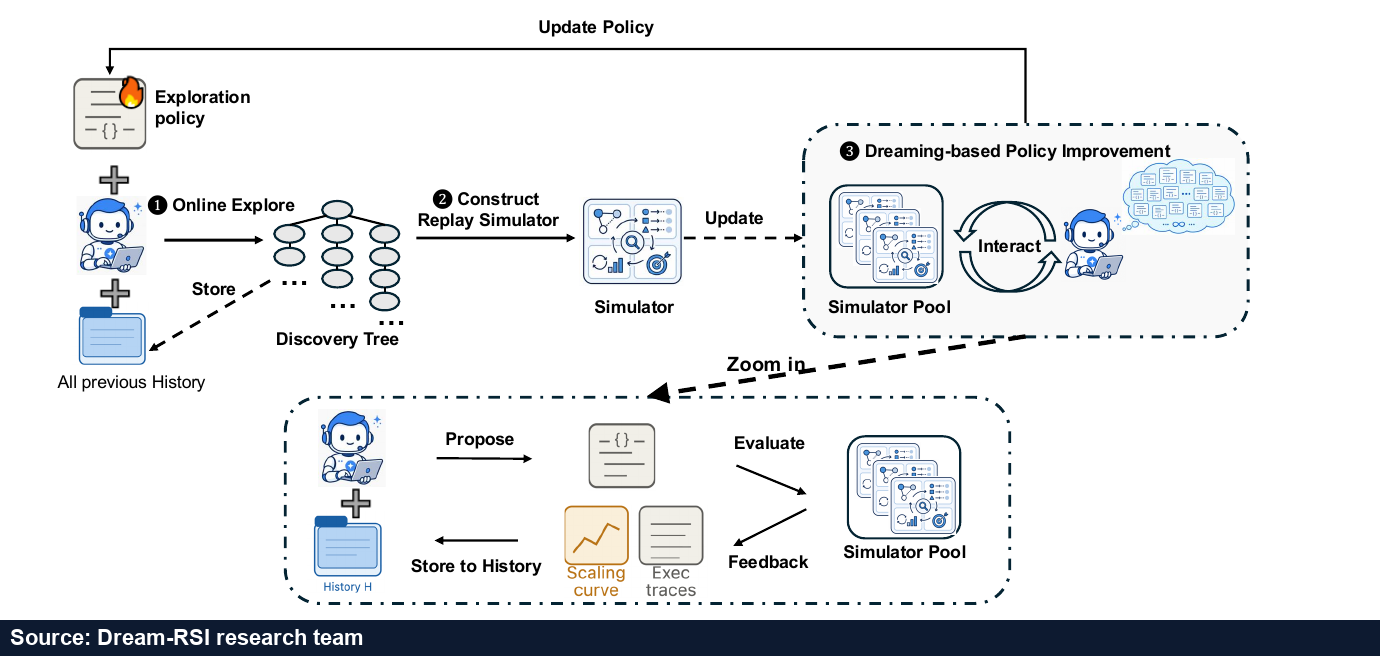
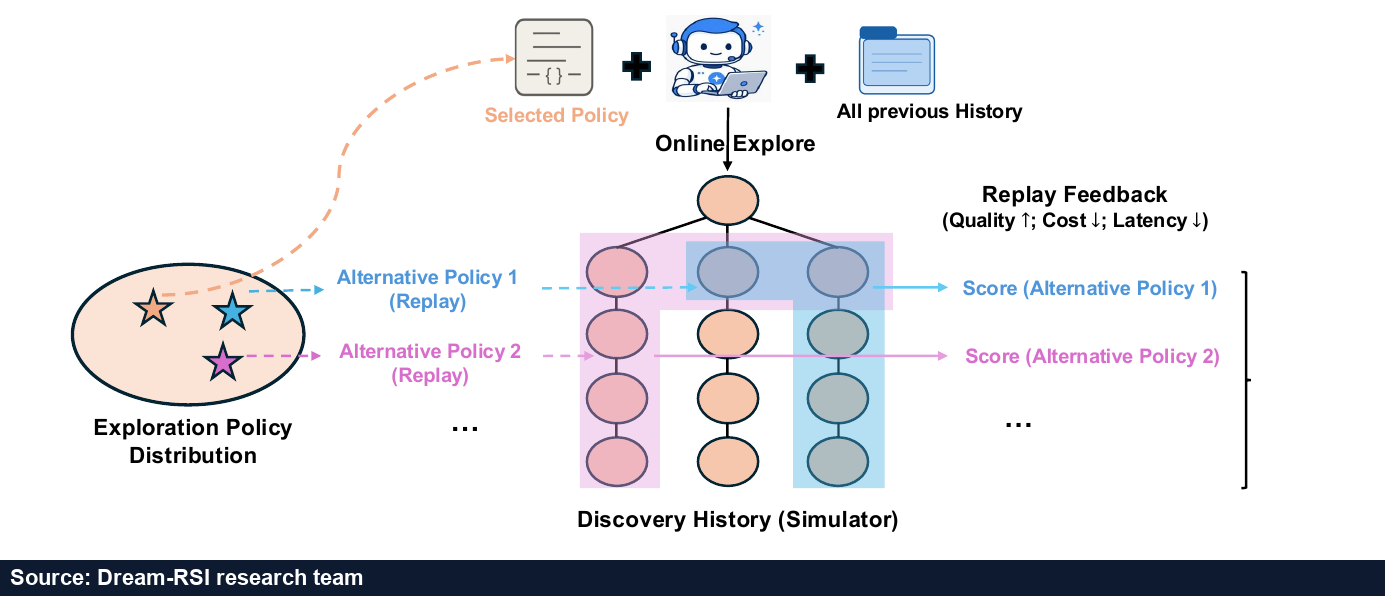
Dream-RSI beginnt mit einer Erkundungsstrategie: Sie legt fest, was als Nächstes ausprobiert wird. Ein Programmieragent erkundet eine Aufgabe und speichert die genommenen Wege als Entdeckungsbaum. Diese Geschichte wird zum Replay-Simulator. Andere Strategien lassen sich darin prüfen, ohne jedes teure Experiment erneut auszuführen.
Der Kanal erklärt den Ansatz anhand der Äste dieses Baums. Alles erneut zu erkunden wäre teuer. Nur eine bekannte Antwort auswendig zu lernen lässt wenig Anpassung zu. Die Wiederholung im bereits erkundeten Teil erlaubt den Vergleich anderer Entscheidungen und nutzt die vorhandene Arbeit weiter.
Wie die Schleife weiterläuft
Nach dem Vergleich kehrt die verbesserte Strategie in die tatsächliche Erkundung zurück. Sie sammelt neue Erfahrungen und erzeugt einen weiteren Entdeckungsbaum. Der Bestand an gespeicherten Abläufen wächst und bietet der nächsten Runde mehr Lernmaterial. Diesen Ablauf nennt die Arbeit Dreaming.
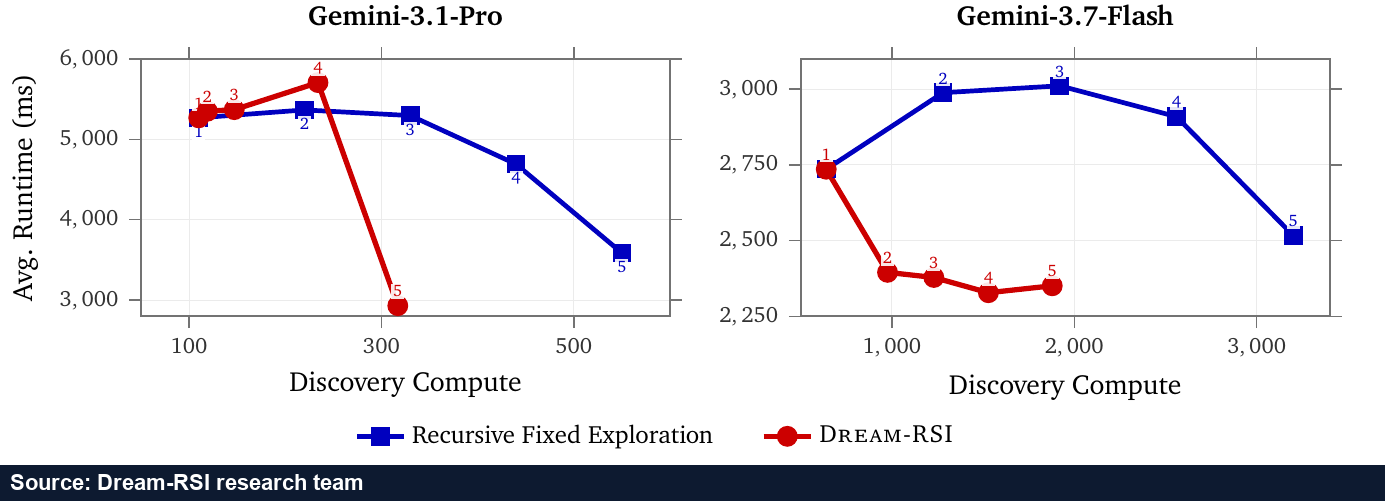
Die veröffentlichten Beispiele umfassen Algorithmusentwicklung, mathematische Optimierung und die Entwicklung von GPU-Kernels. Diagramme verbinden Erkundung, Wiederholung und Strategieänderung; Vergleichsgrafiken stellen Qualität und Rechenaufwand gegenüber. Der Podcast präsentiert die Arbeiten als Ergänzungen: Die eine definiert Stufen, die andere entwickelt einen Mechanismus zur Verbesserung von Agenten.

