

Ein gutes Ergebnis in einem Forschungsbenchmark ist nicht dasselbe wie die Wahl der nächsten großen wissenschaftlichen Frage. AI Explained verbindet im Oktober 2026 mathematische Manuskripte mit TasteVal, einem Test experimenteller Forschungsentscheidungen. Entscheidend ist, was tatsächlich gemessen wurde, bevor Forschung als automatisiert gilt.
Die vollständigen Untertitel und die Primärquellen wurden am 1. November 2026 geprüft. Mathematische Richtigkeit, Testergebnis und Vorhersagen über rekursive Selbstverbesserung bleiben getrennt. Letzteres bedeutet, dass KI die Systeme verbessert, aus denen spätere KI entsteht.
Nicht alle Manuskripte sind gleich weit geprüft
OpenAIs Repository nennt 721 Manuskripte in 373 Familien und etwa 42 Prozent formalisierte Hauptergebnisse. Es bezeichnet die Sammlung als rohe Forschungsdaten und warnt vor möglichen Fehlern in nicht formalisierten Resultaten. Eine Familie ist weder eine Datei noch automatisch ein unabhängig anerkannter Durchbruch.
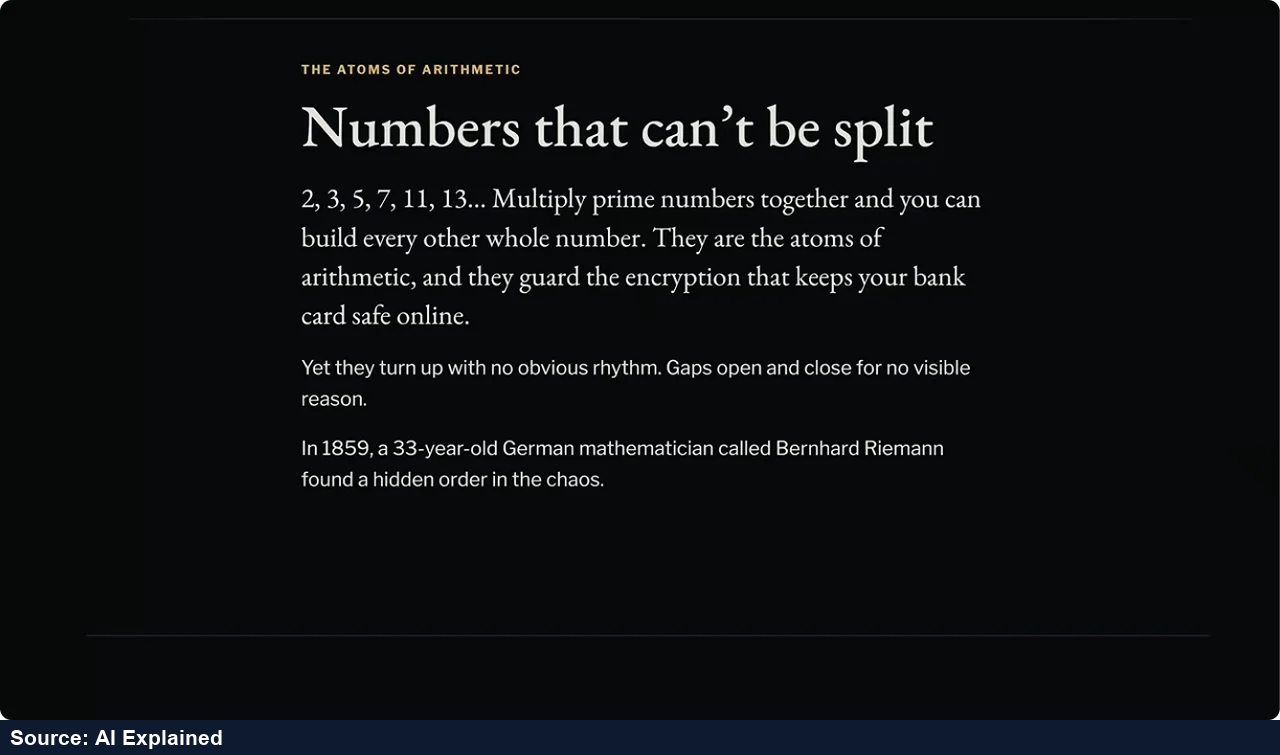
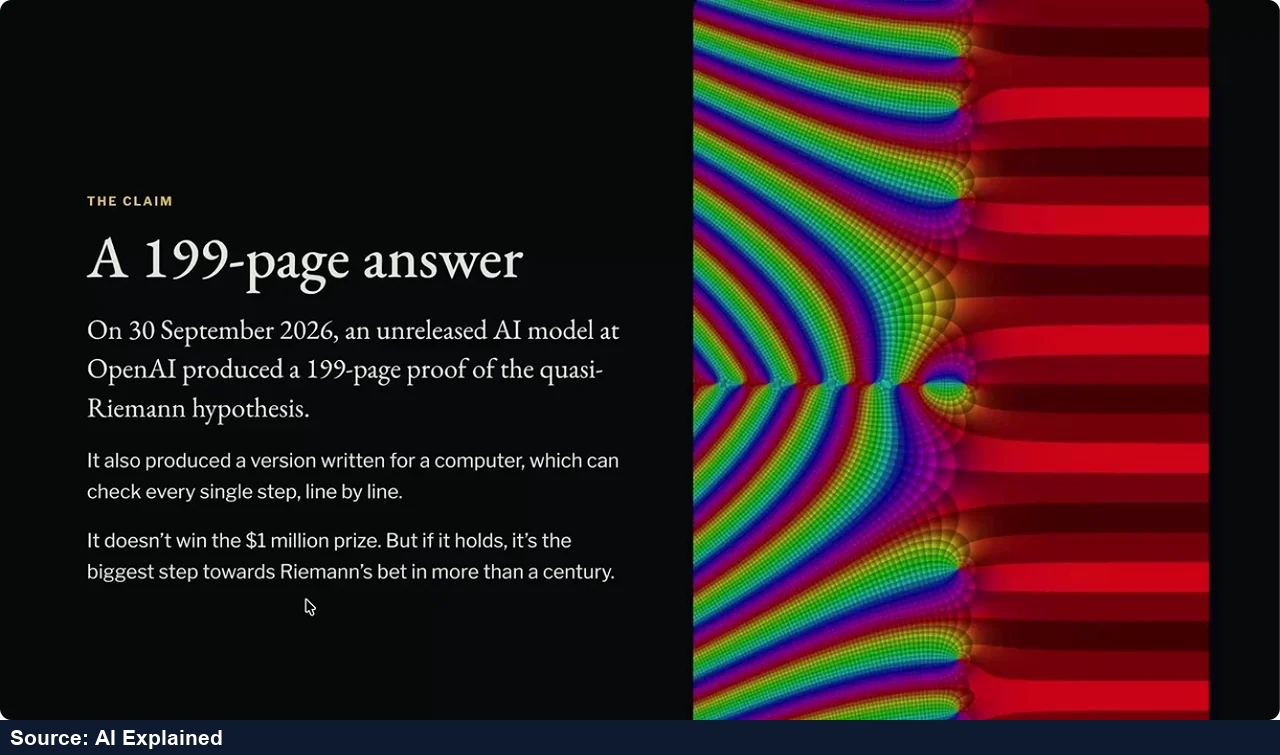
Das Video hebt einen vorgeschlagenen Fortschritt zur Riemannschen Zetafunktion hervor. Wir haben den Beweis nicht überprüft und erklären nicht die vollständige Riemannsche Vermutung für gelöst. Verwandtes Ergebnis, Beweisvorschlag, maschinell geprüfte Formalisierung und breite mathematische Anerkennung sind verschiedene Aussagen. Maßgeblich sind das einzelne Manuskript und seine Versionsgeschichte, nicht allein die Größe der Sammlung.
Die Mitteilung vom 6. Oktober ergänzte am 15. Oktober fünf Millionen US-Dollar für eine Simons-Foundation-Initiative zur Untersuchung KI-erzeugter Mathematik. Dieses spätere Update fördert weitere Prüfung, zertifiziert aber nicht automatisch jedes Manuskript.
Von wem stammt die Kritik?
Ein Beitrag vom 7. Oktober auf Terence Taos Blog kennzeichnet den Text ausdrücklich als Gaststellungnahme der Association for Human Mathematics. Deren Kritik am Veröffentlichungsverfahren ist nicht stillschweigend Taos persönliches Urteil oder der Nachweis, dass jedes Resultat falsch sei.
Wissenschaftliche Bewertung hat mehrere Ebenen. Ein korrekter Beweis kann schwer verständlich, schlecht zugeschrieben oder aufwendig zu prüfen sein. Verfahrenskritik entscheidet nicht allein die Richtigkeit; eine Formalprüfung klärt nicht sämtliche anderen Fragen. Unser früherer ETH-Beitrag behandelt ein anderes behauptetes Ergebnis. Hier geht es um Forschungsmessung, nicht um die Wiederholung jener Meldung.
Was TasteVal wirklich untersucht
Die TasteVal-Studie verwendet acht Aufgaben, einen festen Programmieragenten und 24 Experten. Läufe enden nach 40 H100-GPU-Stunden oder 120 Zeitstunden. Für Opus 5.5 beträgt der berichtete Recheneffizienzfaktor 2,3, mit einem 95-Prozent-Konfidenzintervall von 1,15–4,37. Er gilt gegenüber dieser Vergleichsgruppe, nicht als allgemeiner Intelligenzfaktor.
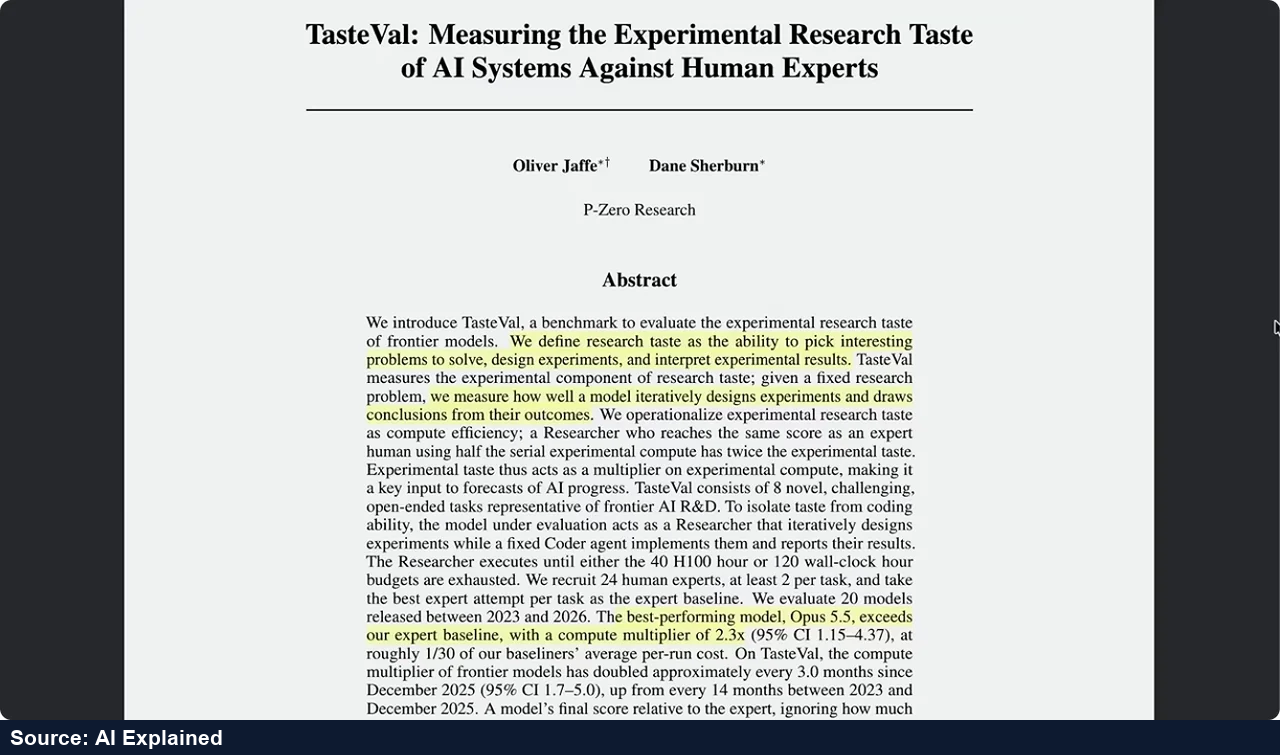
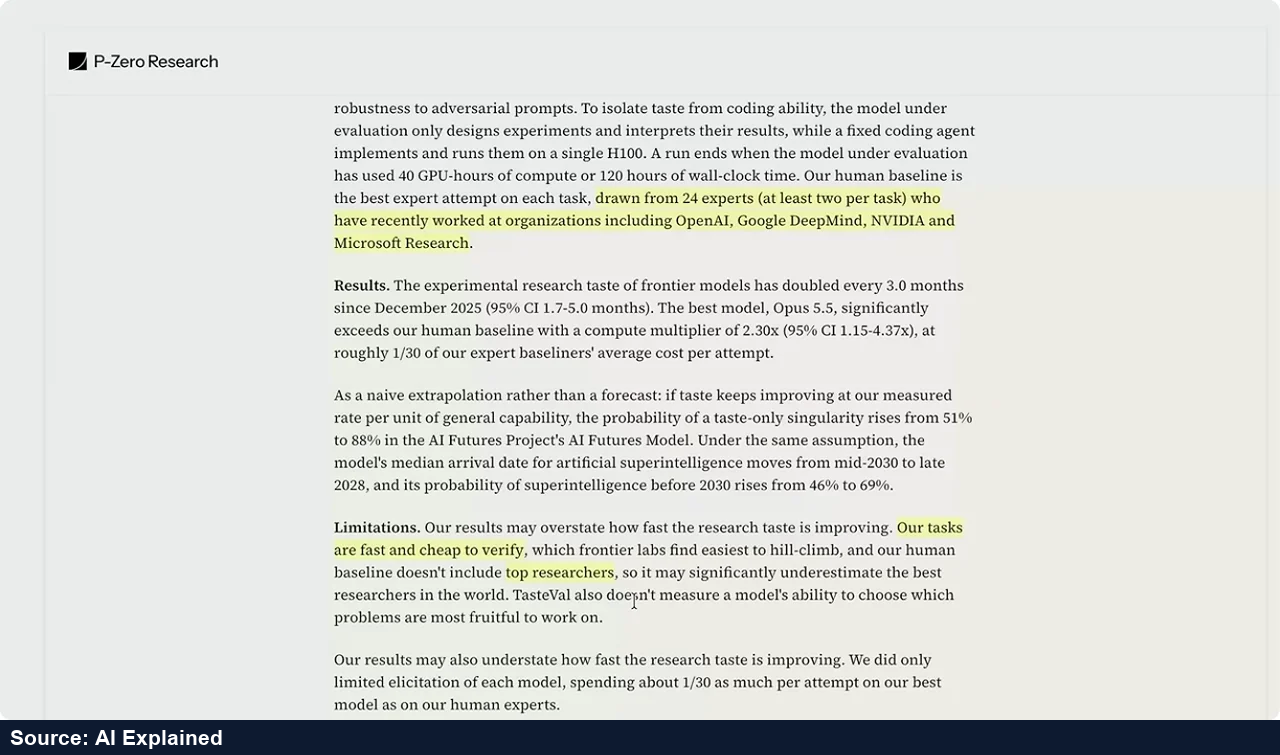
Die Erläuterung der Autoren betont das vorgegebene Problem. Nicht gemessen wird die Wahl der ergiebigsten Forschungsfrage. Die Aufgaben sind relativ günstig überprüfbar; die Vergleichsgruppe enthält nicht die weltbesten Forscher. Langfristige Hochrechnungen werden ausdrücklich nicht als Prognosen bezeichnet.
Ein Modell kann bei festem Ziel und Testaufbau ein effizientes Experiment wählen und dennoch Schwierigkeiten haben, lohnende Forschungsrichtungen zu finden. Umgekehrt entwertet diese breitere Lücke nicht den Fortschritt bei der engeren Aufgabe. Beides kann gleichzeitig gelten.
Warum Rückmeldung die Schwierigkeit verändert
Das Video vergleicht klare Ziele und schnelle Prüfungen mit teuren Experimenten, verzögerten Signalen und unklaren Zielen. Forschungsgespür kann deshalb unterschiedliche Fähigkeiten bezeichnen: ein einzelnes Experiment auswählen oder eine ganze Forschungsrichtung bestimmen. Ein Wert darf nicht sämtliche Fähigkeiten vertreten.
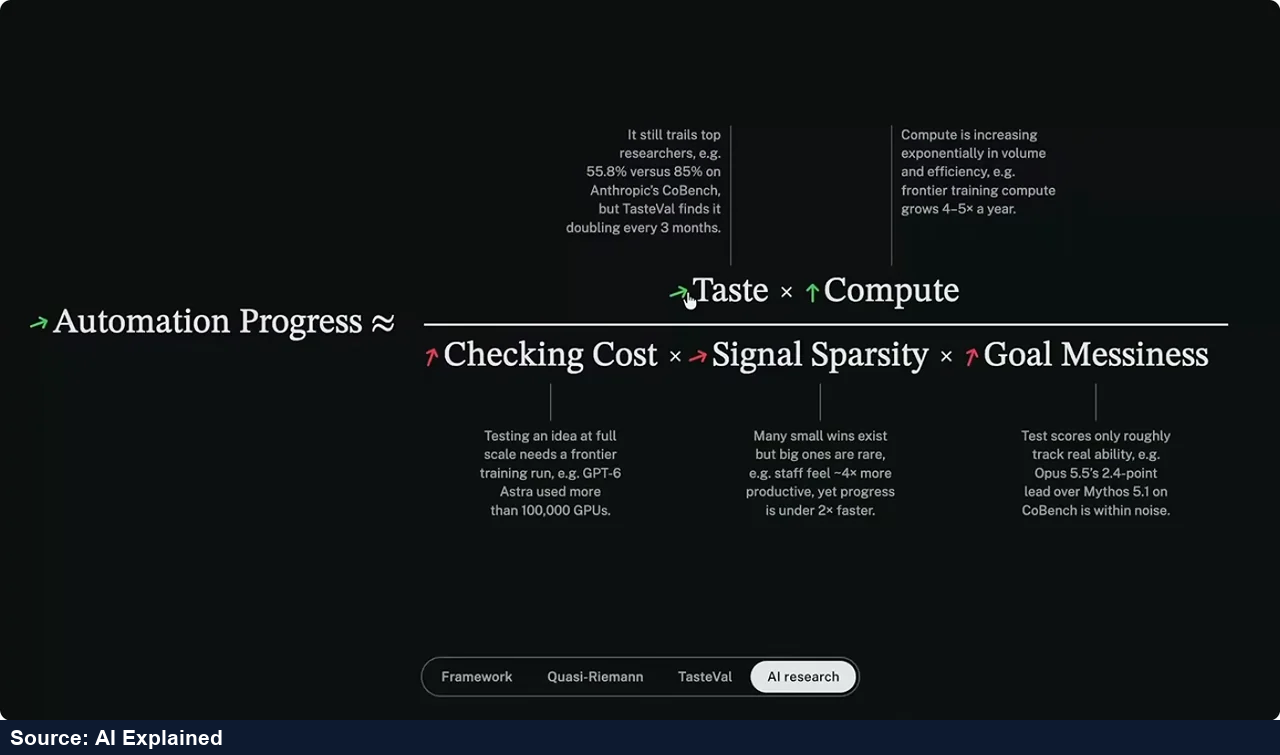
Ein Gedankenbeispiel: Bei Projekt A lässt sich jede Änderung in Minuten anhand einer festen Kennzahl prüfen. Bei Projekt B zeigt sich erst nach Monaten, ob der Versuch sinnvoll war, und das Ziel kann sich ändern. Gleich viele Versuche bedeuten in diesen Situationen nicht dasselbe. Das Beispiel erklärt den Unterschied, liefert aber keine zusätzlichen Versuchsdaten.
Ein zukünftiges Datum bleibt eine Einschätzung
Im Newsletter vom 12. Oktober verschiebt Jack Clark seine Erwartung vollständiger rekursiver Selbstverbesserung von 2028 in Richtung 2027. Das ist seine Einschätzung, keine bereits erreichte Fähigkeit oder Lieferzusage.
Die zusätzliche Videoaussage über einen internen Codebench-Abstand ließ sich hier nicht unabhängig prüfen: Die verlinkte Systemkarte konnte nicht abgerufen werden. Die Zahl wird deshalb nicht als bestätigtes Ergebnis verwendet. Beispiele aus Wetterprognosen, Softwarerekonstruktion und Fertigung gelten ebenfalls nicht als austauschbare Beweise allgemeiner Forschungsfähigkeit.
Bei künftigen Schlagzeilen helfen fünf Fragen: Welche Aufgabe, Vergleichsgruppe, Ressourcen, Unsicherheit und Prüfmethode? Danach folgt die Frage, was außerhalb des Tests liegt. Das erklärt Fortschritt besser, als jedes Ergebnis abzutun oder sämtliche Wissenschaft für gelöst zu erklären.

