

Bir araştırma testinde başarılı olmak, sıradaki büyük bilimsel soruyu seçmekle aynı şey değil. AI Explained, Ekim 2026’daki tartışmasında matematik metinlerini deneysel araştırma kararlarını ölçen TasteVal ile ilişkilendiriyor. Temel ders şu: Araştırma otomatikleşti demeden önce tam olarak neyin ölçüldüğüne bakalım.
Videonun bütün altyazısı okundu ve birincil araştırma kaynakları 1 Kasım 2026’da kontrol edildi. Matematiksel doğruluk, test başarısı ve yinelemeli öz geliştirme tahminleri ayrı tutuluyor. Yinelemeli öz geliştirme, yapay zekânın sonraki yapay zekâyı üreten sistemleri geliştirmeye yardım etmesidir.
Bütün matematik metinleri aynı ölçüde doğrulanmış değil
OpenAI’ın deposu, 373 aile içinde 721 metin ve ana sonuçlarda yaklaşık yüzde 42 biçimsel doğrulama bildiriyor. Koleksiyonu ham araştırma verisi olarak tanımlıyor; biçimselleştirilmemiş sonuçlarda hata olabileceğini belirtiyor. Bir aile; bir dosya, teorem veya bağımsız kabul görmüş buluşla aynı sayım birimi değil.
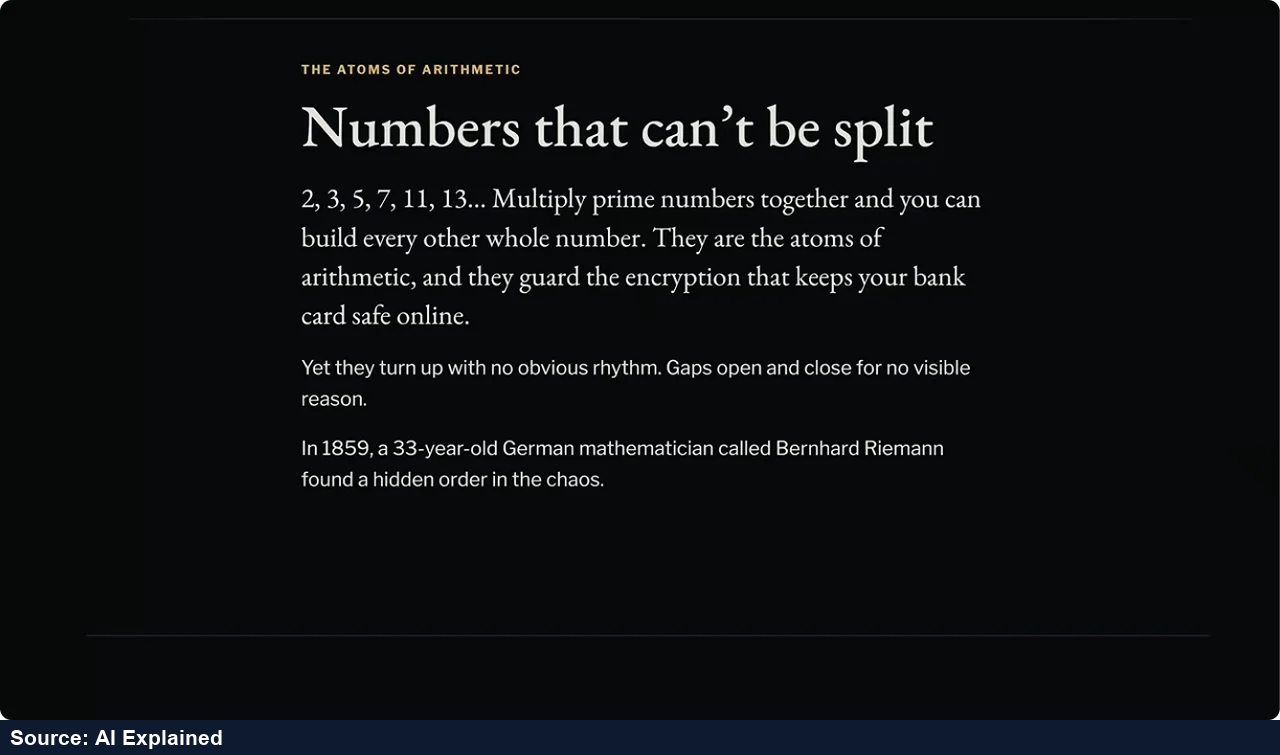
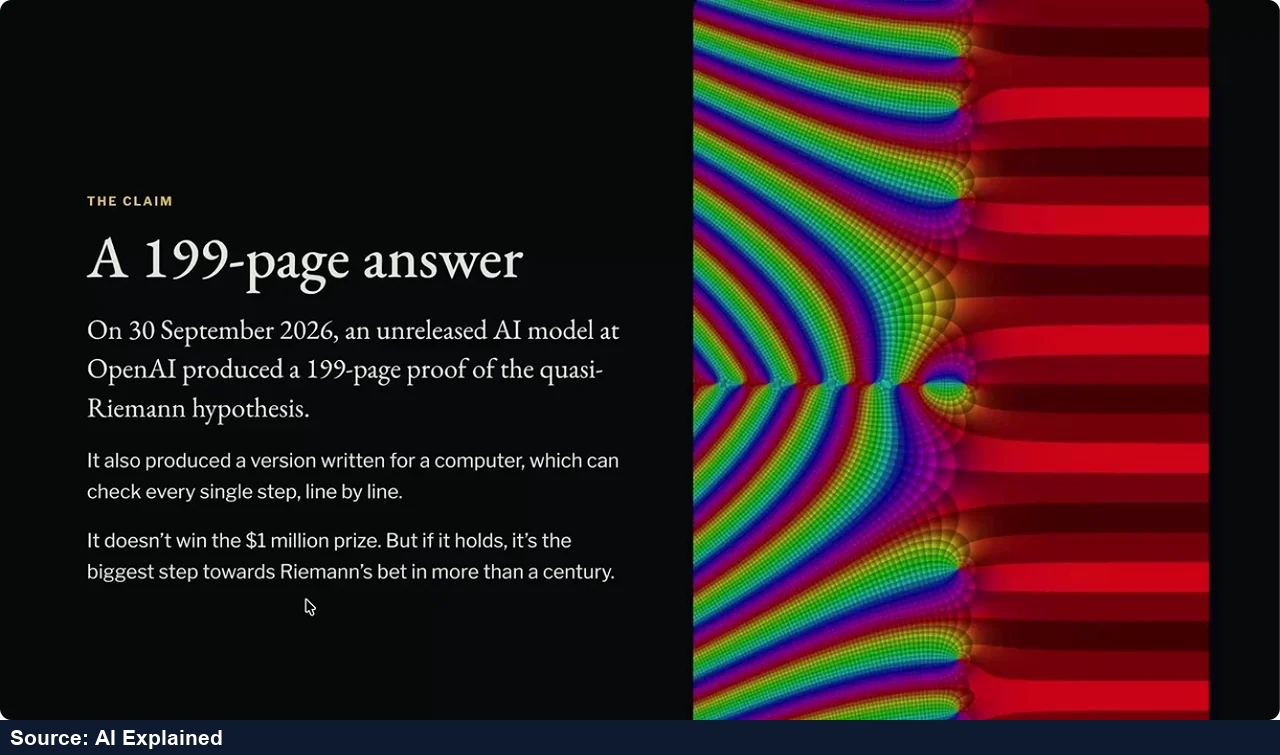
Video, Riemann zeta fonksiyonuyla ilgili bir ilerleme önerisini öne çıkarıyor. Alttaki ispatı burada doğrulamadık ve tam Riemann hipotezi çözüldü demiyoruz. İlgili bir sonuç, ispat önerisi, makineyle denetlenmiş biçimsel ispat ve matematik dünyasında genel kabul ayrı iddialardır. Koleksiyonun büyüklüğünden doğruluk çıkarmak yerine ilgili metni ve değişiklik geçmişini izlemek gerekir.
6 Ekim duyurusuna, 15 Ekim’de AI üretimi matematiği inceleyen Simons Foundation girişimine 5 milyon dolarlık destek eklendi. Bu güncelleme videodan sonra geldi. Daha fazla incelemeyi destekliyor; bütün metinleri kendiliğinden doğrulamıyor.
Eleştiriyi kim yaptı?
Terence Tao blogundaki 7 Ekim yazısı, açıkça Association for Human Mathematics’in konuk bildirisi olarak tanımlanıyor. Yayımlama yöntemine yönelik eleştiri bu gruba atfedilmeli; sessizce Tao’nun kişisel hükmüne veya bütün sonuçların yanlış olduğunun kanıtına dönüştürülmemeli.
Bilimsel değerlendirme tek eksenli değil. Teknik olarak doğru ispatın anlatımı güç, atıfları yetersiz veya kontrolü pahalı olabilir. Yayın yöntemine itiraz, tek başına doğruluk meselesini çözmez. Biçimsel denetim de diğer sorunların hepsini çözmez. Önceki ETH yazımız başka bir sonuç iddiasını ele alıyor. Buradaki odak o duyuruyu tekrar etmek değil, araştırma yeteneğini ölçmek.
TasteVal gerçekte neyi ölçüyor?
TasteVal makalesinde sekiz görev, sabit kodlama ajanı ve 24 uzman var. Denemeler 40 H100 GPU-saat veya 120 gerçek saat sınırında bitiyor. Opus 5.5 için hesaplama verimliliği çarpanı 2,3; yüzde 95 güven aralığı 1,15–4,37. Bu, testteki insan temel çizgisine göre verimlilik; evrensel zekâ çarpanı değil.
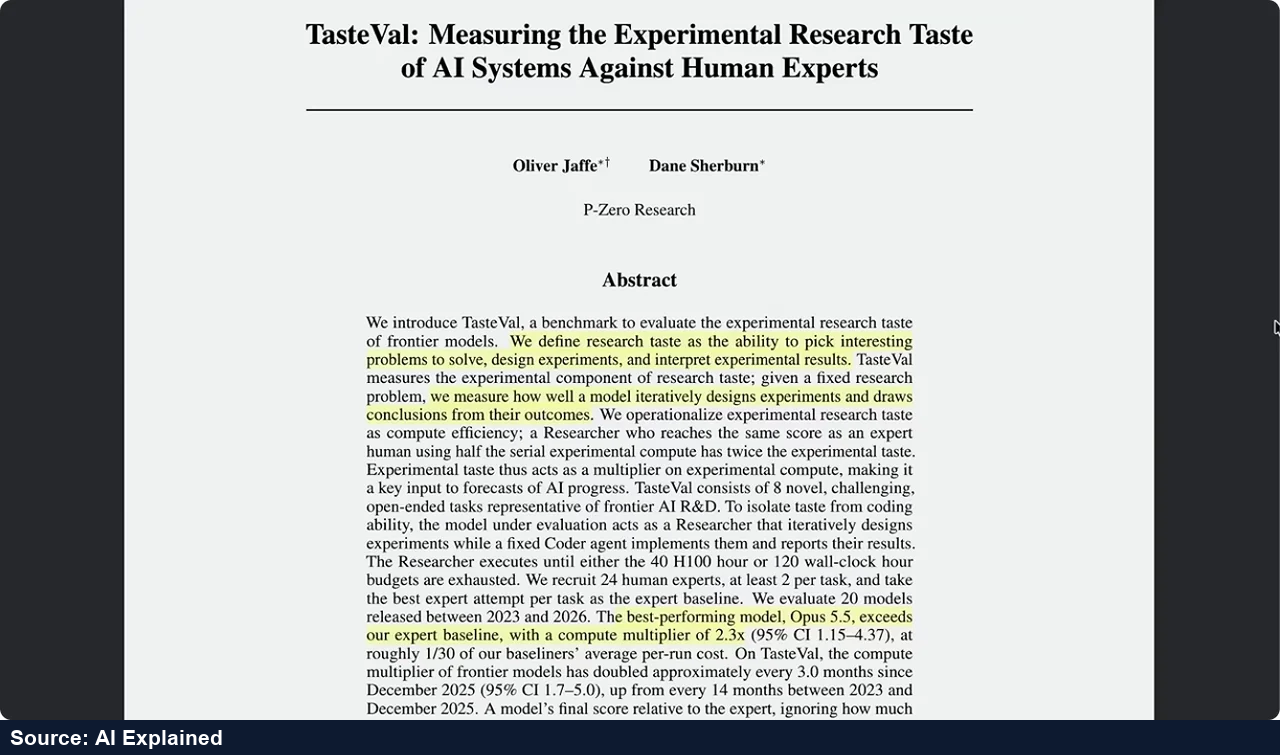
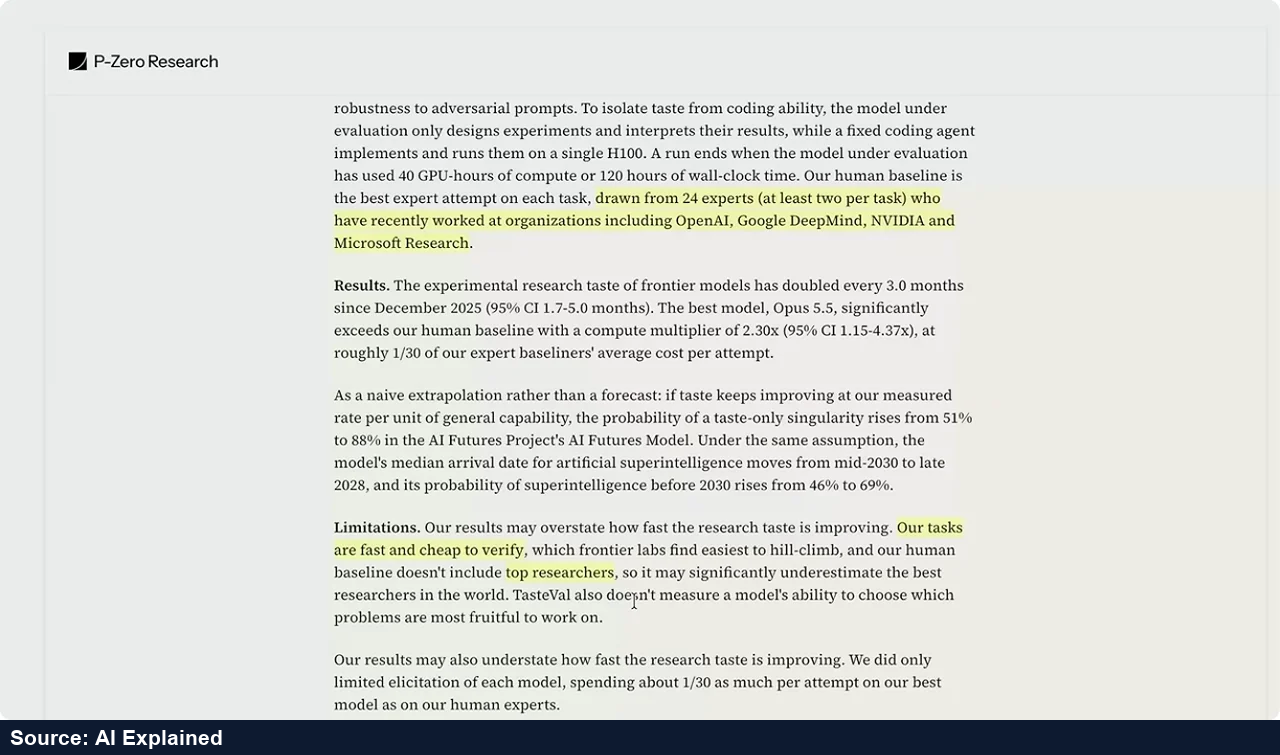
Yazarların açıklaması, problemin baştan verildiğini vurguluyor. En verimli araştırma sorusunu seçme ölçülmüyor. Görevlerin doğrulaması görece ucuz; insan karşılaştırması dünyanın en iyi araştırmacılarını içermiyor. Uzun vadeli çıkarımlar da kesin öngörü değil, eğilimi ileri uzatma olarak sunuluyor.
Hedef ve test düzeni hazırken model verimli deney seçebilir; buna rağmen neyi araştırmaya değer bulacağını belirlemekte zorlanabilir. Tersine, geniş becerinin eksikliği dar görevdeki gerçek ilerlemeyi silmez. İkisi aynı anda doğru olabilir.
Geri bildirim neden zorluğu değiştiriyor?
Video; açık hedef ve hızlı kontrolü, pahalı deney, geciken sinyal ve belirsiz hedefle karşılaştırıyor. Bu yüzden araştırma sezgisi farklı beceriler anlamına gelebilir: tek deney seçmekten bütün araştırma yönünü belirlemeye kadar. Bir puan bunların hepsinin yerine konmamalı.
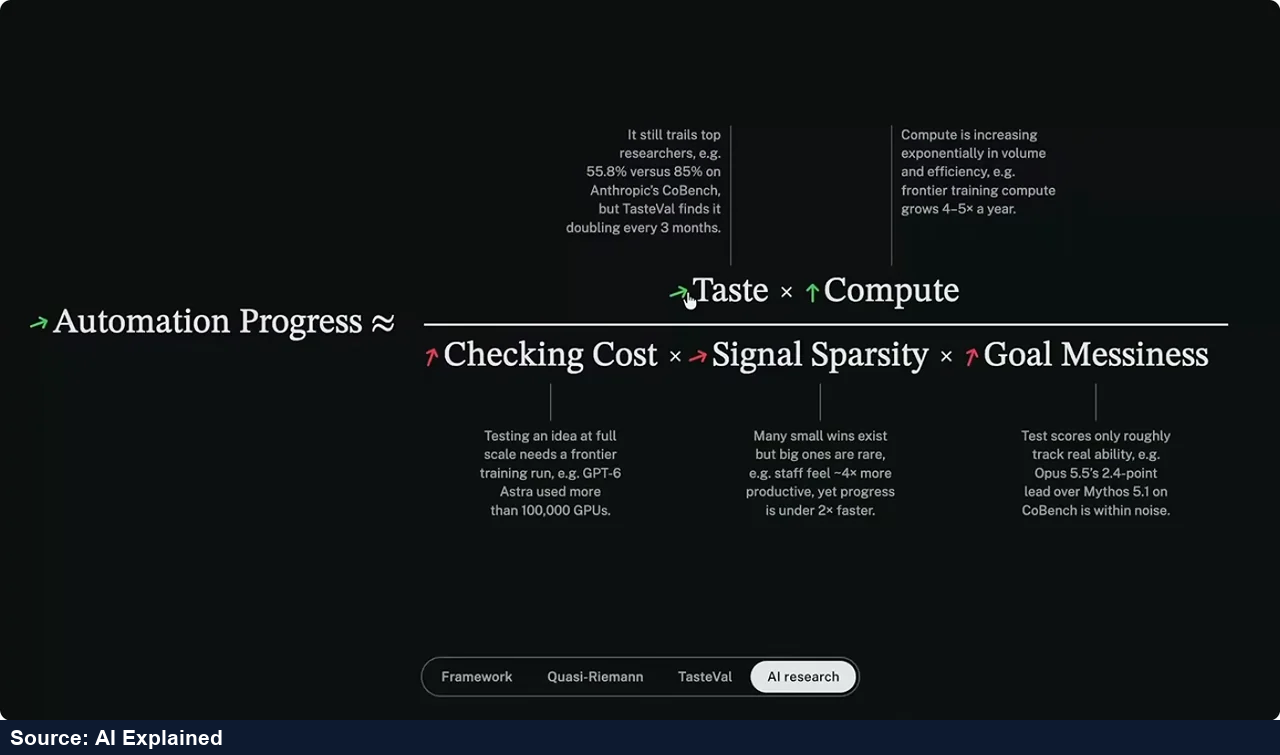
Varsayımsal iki proje düşünün. Birinde her değişiklik sabit ölçüte göre dakikalar içinde sınanıyor. Diğerinde deneyin değerli olup olmadığını anlamak aylar sürüyor, hedef de değişebiliyor. Aynı sayıda deneme bu iki ortamda aynı anlama gelmez. Bu örnek farkı açıklıyor; ek deneysel kanıt sunmuyor.
Gelecekteki tarih yine bir tahmin
Jack Clark, 12 Ekim bülteninde tam yinelemeli öz geliştirme beklentisini 2028 yerine 2027’ye yaklaştırıyor. Bu kişisel değerlendirme; gerçekleşmiş yetenek veya teslim tarihi değil.
Videonun iç Codebench farkına ilişkin ek iddiası burada bağımsız doğrulanamadı; bağlantıdaki sistem kartı alınamadı. Bu sayı doğrulanmış sonuç olarak kullanılmıyor. Hava tahmini, yazılımı yeniden oluşturma ve fiziksel üretim örnekleri de genel araştırma yeteneğinin birbirinin yerine geçen kanıtları sayılmıyor.
Yeni bir araştırma haberinde görevi, insan karşılaştırmasını, kaynak bütçesini, belirsizlik aralığını ve doğrulama yöntemini kontrol edin. Sonra testin dışında ne kaldığını sorun. Bu yaklaşım, her sonucu reddetmekten de bütün bilim çözüldü demekten de daha yararlı bir ilerleme tablosu verir.

