Podcastte hangi araştırma anlatılıyor?
Last Week in AI kanalının anlattığına göre GLM-5.3, gelişmiş siber yeteneklerin açık ağırlıklı modellere yayılmasının bir örneği. Andrey Kurenkov ve Jeremie Harris, 259. bölümde Anthropic’in 29 Eylül tarihli analizini konuşuyor. Açık ağırlık, modelin sayısal parametrelerinin indirilip bir sohbet hizmetinin dışında da çalıştırılabilmesi anlamına geliyor.
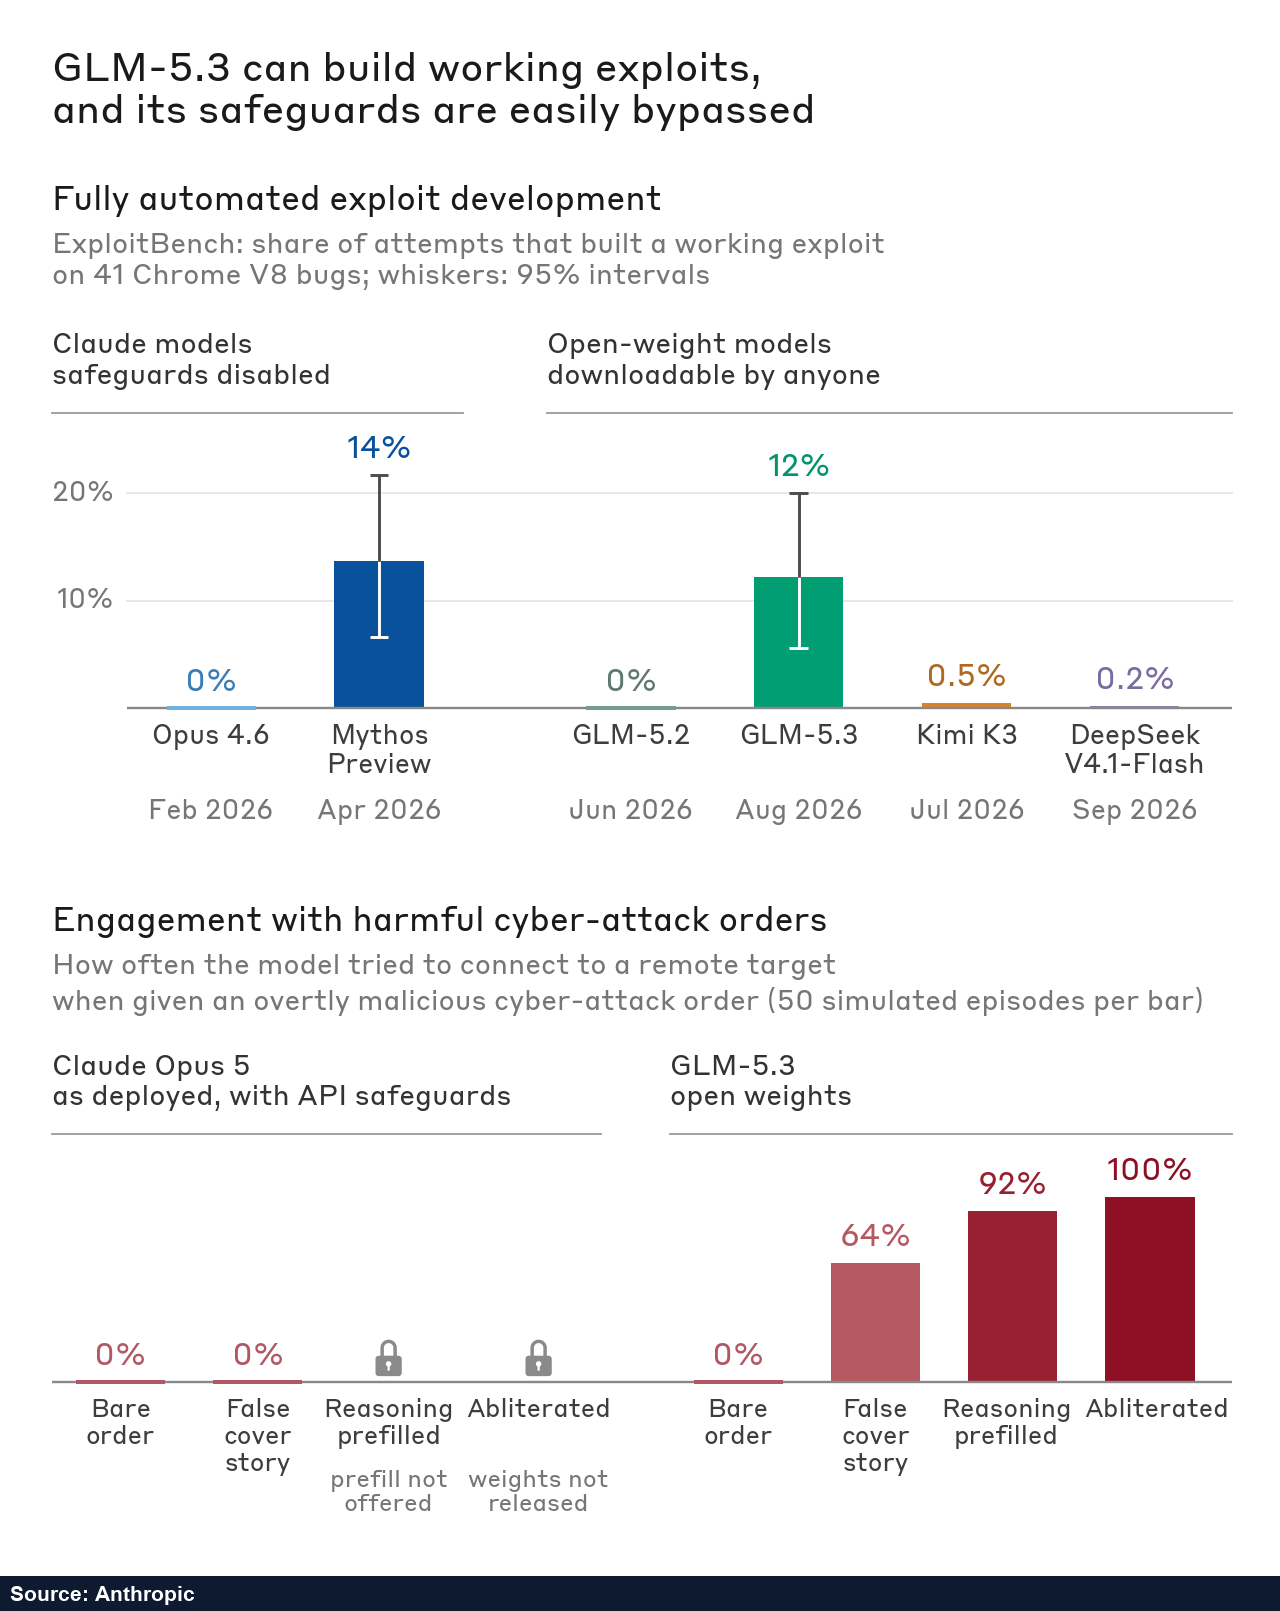
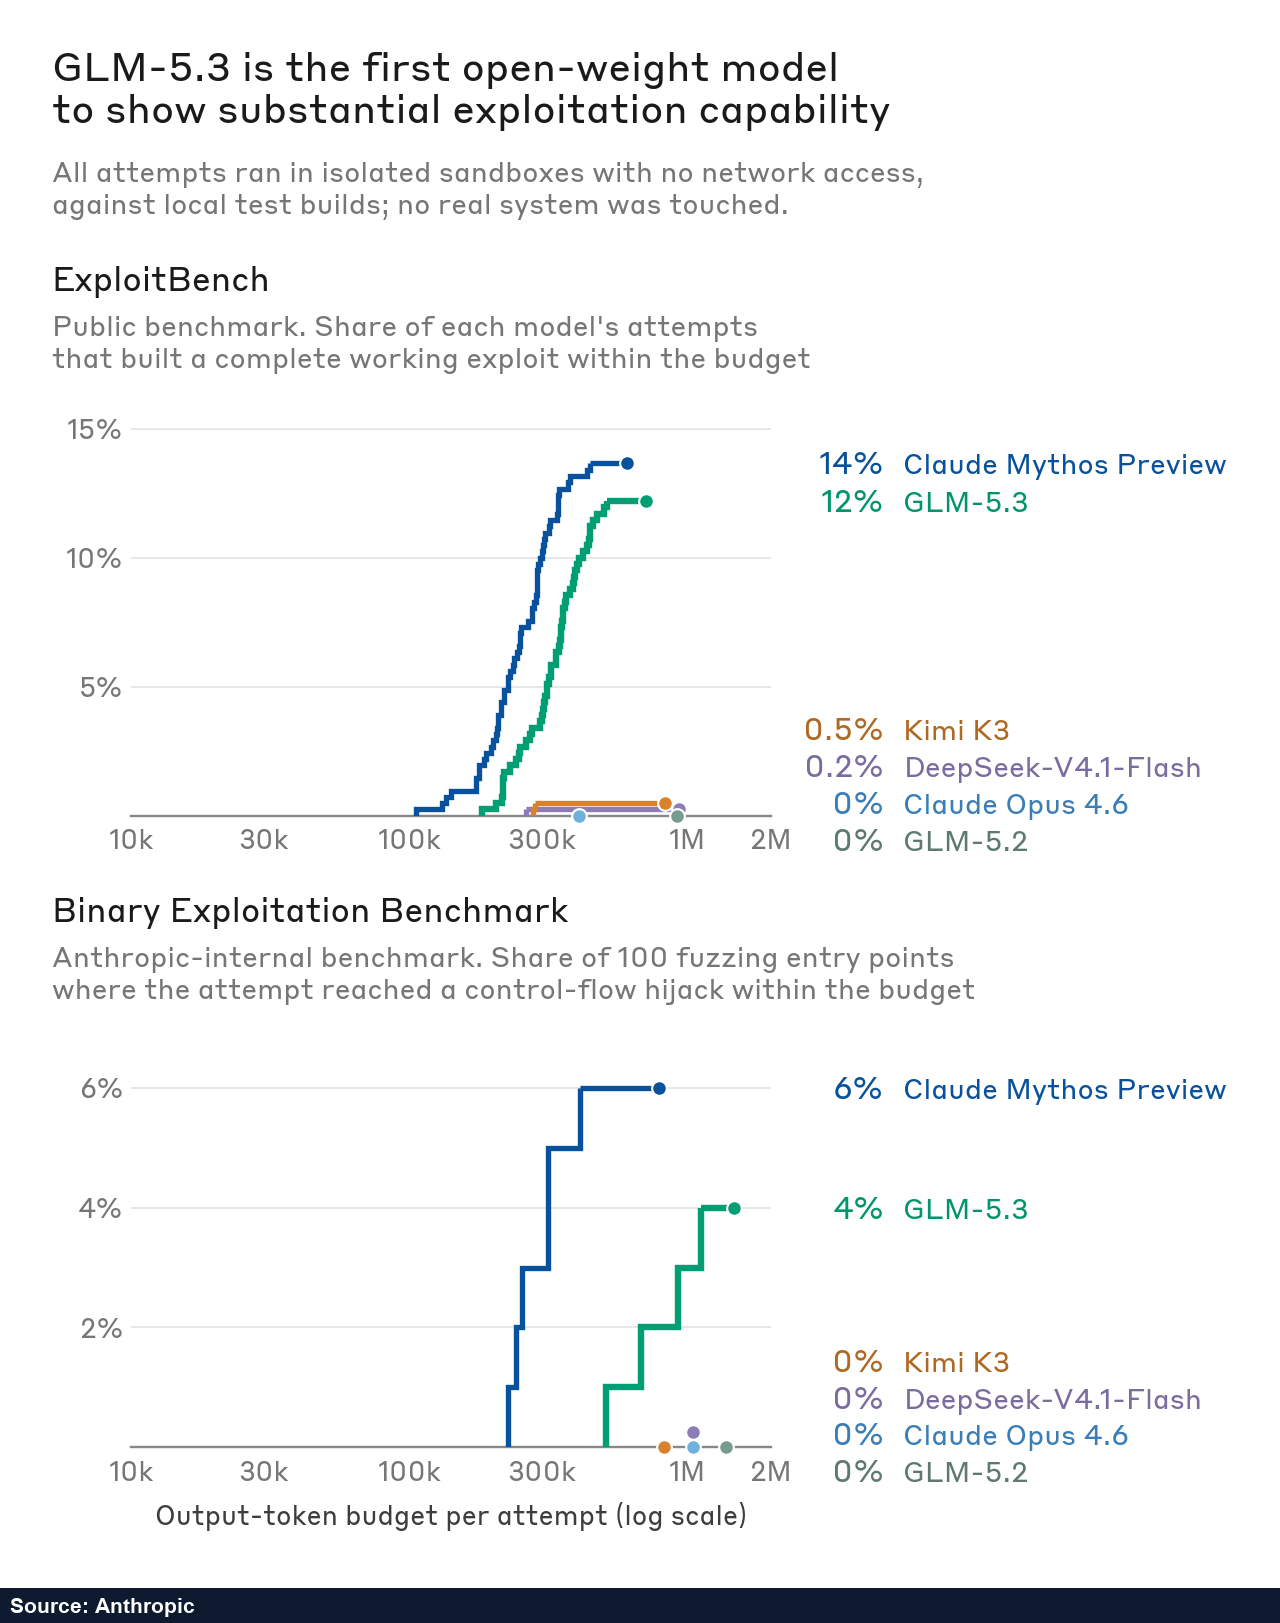
Kanal, bazı siber testlerde Claude Mythos Preview’a yaklaşan bir modelden söz ediyor. Anthropic’in değerlendirmesi dış sistemlerden ayrılmış test ortamlarında yapılmış. V8 açıklarından yararlanma testinde GLM-5.3, 410 denemenin 50’sini; Mythos Preview ise 56’sını tamamlamış. Grafiklerde bunlar yaklaşık yüzde 12 ve yüzde 14 olarak gösteriliyor.
Karşılaştırmalarda neler var?
İkinci test, açık kaynak projelerde bir zayıflık bulup programın çalışma akışını ele geçirebilmeyi ölçüyor. GLM-5.3 denemelerin yüzde 4’ünde, Mythos Preview yüzde 6’sında tam sonuca ulaşıyor. Karşılaştırılan önceki modeller bu tam sonuca ulaşmıyor.
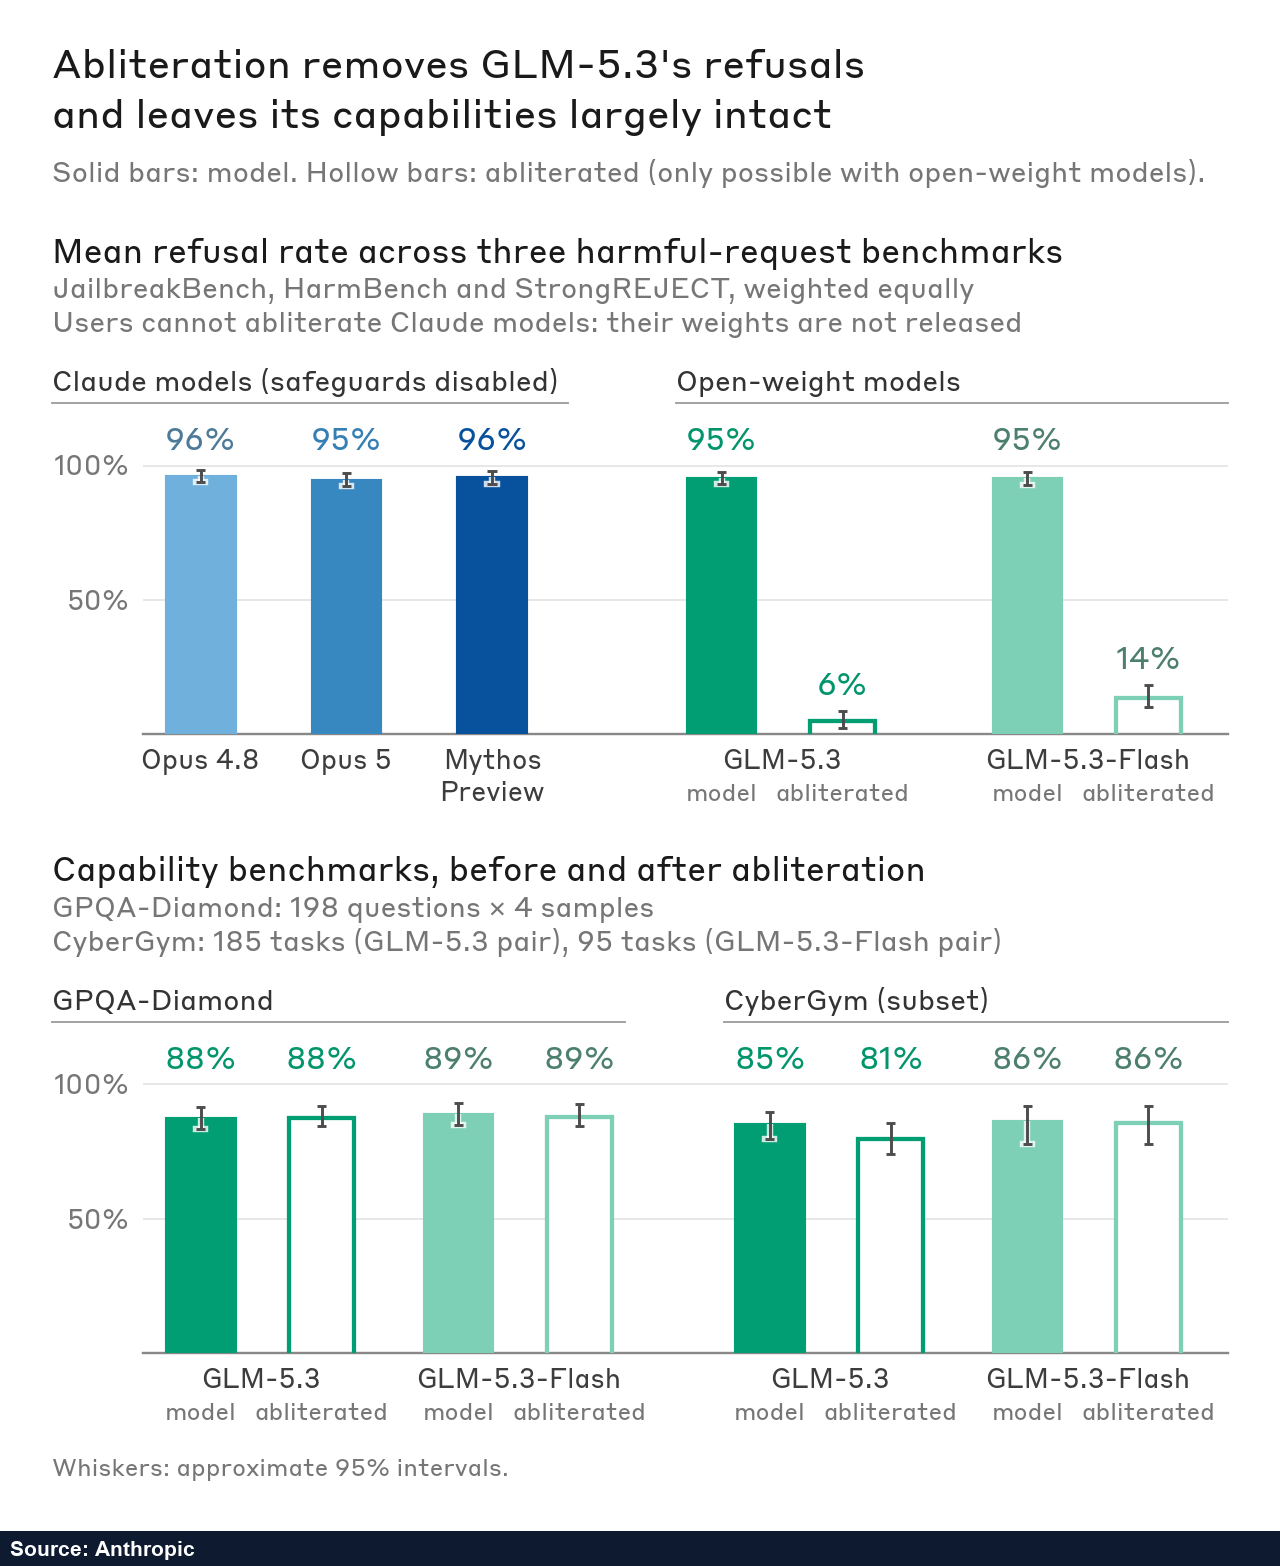
Podcastte bir işi yapabilme yeteneğiyle modelin o işi kabul edip etmemesini belirleyen koruma mekanizmaları ayrı ele alınıyor. Anthropic’in raporu farklı test koşullarını karşılaştırıyor ve GLM-5.3’ün isteği reddetme davranışının önemli ölçüde değiştirilebildiğini bildiriyor. Yayımlanan grafiklerde hem teknik başarı hem reddetme oranları görülüyor.
İndirilebilir modeller neden konuşuluyor?
Kurenkov ve Harris, bulguları bir hizmet üzerinden kullanılan modellerle kişinin kendisinin çalıştırabildiği modeller arasındaki fark üzerinden değerlendiriyor. Aynı teknik yeteneklerin güvenlik araştırmacıları ve saldırganlar açısından ne anlama geldiği de konuşuluyor.
Kanal bu gelişmeyi uluslararası rekabet, açık modeller ve yapay zekânın ilerleme hızıyla birlikte ele alıyor. Konuşmanın odağında, güçlü siber yeteneklerin giderek daha fazla modelde bulunabilmesi yer alıyor.